Cuando una aplicación empresarial o una plataforma de comercio electrónico escala en volumen de usuarios, el backend experimenta una degradación silenciosa pero devastadora: el incremento de la latencia en las consultas de datos. Una respuesta de servidor que tarda más de 200 milisegundos destruye la retención de usuarios, reduce las tasas de conversión y eleva los costos operativos de infraestructura en la nube. Intentar solucionar este problema simplemente pagando por un hosting con mayor memoria RAM o CPU es un parche ineficiente que no ataca la raíz del fallo.
Para mantener una velocidad de carga óptima bajo picos de tráfico masivo, los administradores de TI deben implementar una arquitectura de optimización estructurada en dos niveles: la indexación inteligente a nivel de almacenamiento y el despliegue de capas de memoria transitoria. En esta guía de optimización de infraestructura, aprenderás cómo reducir la latencia de tu base de datos utilizando índices lógicos y almacenamiento en caché asíncrono para garantizar una disponibilidad ultra rápida.
La Anatomía del Retraso: El Escaneo Completo de Tablas (Table Scan)
El colapso de los tiempos de respuesta ocurre casi siempre por una falta de estructuras de búsqueda directa en el motor relacional.
- Búsquedas Secuenciales Ciegas: Si tu base de datos procesa una consulta para buscar un cliente por su número de identificación en una tabla con un millón de registros sin indexar, el motor se ve obligado a leer físicamente una por una las filas del disco duro. Este proceso consume hilos del procesador de forma masiva.
- Bloqueo por Concurrencia: Mientras el motor realiza ese escaneo secuencial masivo, las demás peticiones entrantes se encolan en el servidor, elevando la latencia general del sistema de forma exponencial y provocando caídas por desbordamiento de conexiones (Timeout).
CONTENIDO RELACIONADO:
Sincronizar inventario en tiempo real: Cómo diseñar un backend relacional anti-sobreventa con Airtable
La Estrategia Core: Arquitectura de Consultas en Dos Niveles (Caché + Indexación)
Para estructurar una infraestructura digital capaz de soportar picos transaccionales masivos, la arquitectura de datos no puede depender de consultas directas y lineales al almacenamiento físico. Los entornos corporativos modernos requieren la implementación de un ecosistema híbrido que interconecte tu base de datos relacional (como PostgreSQL o MySQL) con una capa perimetral de almacenamiento en memoria caché de ultra velocidad utilizando Redis.
⚡ Flujo de Consulta Optimizado en Memoria RAM
│
▼
¿Existe en Caché Redis?
├──► [SÍ (Cache Hit: 2ms)] ──► Devuelve JSON al Usuario
└──► [NO (Cache Miss)] ───┐
▼
[Busca en DB Indexada (50ms)]
│
▼
[Guarda en Redis para Futuras Consultas]
Código Técnico para Crear Índices de Rendimiento (Script B2B)
El primer paso de optimización física es aplicar índices de tipo árbol B (B-Tree) sobre las columnas más consultadas en tus cláusulas WHERE. Esto genera un mapa de punteros lógicos que le permite al motor hallar cualquier dato en milisegundos:
SQL
Al ejecutar esta directiva en tu consola de administración, el motor estructura la columna en memoria secuencial, reduciendo drásticamente la latencia en búsquedas contables.
Solución a un Problema de Trinchera: Los Datos Obsoletos en Caché (Stale Data)
Un error operativo muy crítico que sufren los desarrolladores cuando implementan capas de almacenamiento en caché es la desincronización de información. Si guardas los datos del perfil de un cliente en Redis para no consultar la base de datos principal, y el usuario modifica su dirección de envío, tu backend podría seguir leyendo los datos viejos alojados en la memoria RAM, provocando errores logísticos masivos en los pedidos.
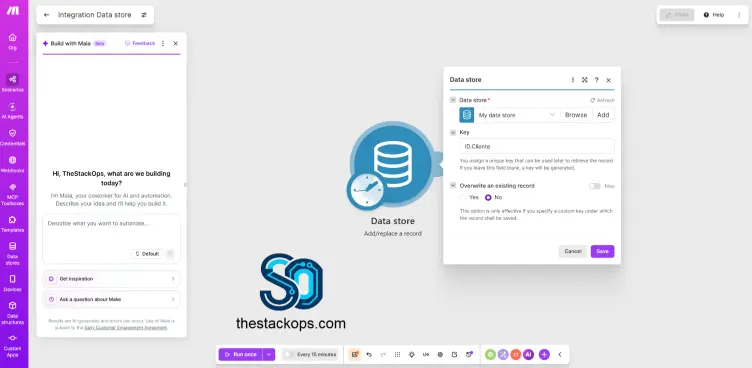
Cómo solucionarlo en producción: Debes aplicar una directiva estricta de tiempo de vida (TTL – Time To Live) a cada clave inyectada en Redis. Al configurar tus flujos de datos en el middleware, programa la expiración automática de los registros transitorios en un umbral máximo de 3600 segundos (1 hora). Adicionalmente, inyecta una función de purga (Cache Invalidation) que destruya instantáneamente la clave en Redis cada vez que se ejecute una sentencia
UPDATEoPUTen tu base de datos maestra.
Matriz de Rendimiento: Bases de Datos Planas vs. Arquitecturas Indexadas con Caché
| Métrica de Infraestructura | Estado Virgen Sin Optimizar | Arquitectura Blindada (Índices + Redis) |
|---|---|---|
| Tiempo de Respuesta (Lectura) | 250 – 800 ms (Altamente inestable) | 2 – 15 ms (Consistente y ultra rápido) |
| Comportamiento ante Tráfico | Latencia lineal ascendente (Colapso) | Tasa de respuesta plana y estable |
| Carga de CPU en el Servidor | Elevada por escaneos de tablas repetidos | Mínima (La RAM absorbe el 80% de peticiones) |
| Estrategia de Almacenamiento | Todo directo al disco duro físico | Híbrida (Persistencia en disco + Caché en RAM) |
Preguntas Frecuentes (FAQ)
¿Es recomendable indexar todas las columnas de una tabla para acelerar el sistema?
No, es una práctica contraproducente. Aunque los índices aceleran drásticamente las consultas de lectura (SELECT), penalizan la velocidad de las escrituras (INSERT, UPDATE y DELETE), ya que el motor debe reconstruir físicamente el mapa del índice cada vez que los datos cambian. Indexa únicamente las columnas de identidad (IDs, SKU, correos) que se usen de forma repetida como filtros de búsqueda.
¿Qué diferencia hay entre usar el Data Store nativo de Make y una base de datos como Redis?
El Data Store de Make funciona de forma excelente como una caché local interna para automatizaciones no-code de volumen medio (hasta 100,000 registros). Sin embargo, si estás optimizando la infraestructura central de una aplicación web masiva en producción con millones de peticiones externas, Redis es el estándar global debido a su capacidad de respuesta al sub-milisegundo y su soporte nativo para estructuras de datos complejas.
Fuentes Oficiales de Ingeniería y Repositorios Técnicos
La validación técnica sobre el rendimiento de consultas y la administración de memoria en memoria RAM analizados en esta guía están respaldados por los manuales de desarrollo oficiales de los motores líderes:
- Manual de Optimización de Consultas y Rendimiento de PostgreSQL Global Development Group
- Documentación Oficial de Arquitectura de Comandos y TTL de Redis Open Source
Conclusión
Aprender a reducir la latencia de tu base de datos transforma por completo la escalabilidad operativa de tu infraestructura digital. Al combinar índices condicionales precisos a nivel físico con políticas estrictas de expiración TTL en tu capa de memoria transitoria, erradicas los cuellos de botella de tu servidor, minimizas los costos de hosting y garantizas una velocidad de carga de nivel corporativo capaz de soportar picos transaccionales masivos sin pestañear.